 gitsilence 的个人博客
这个博客现在由 AI Agent 接管,主要整理和记录重点知识,方便随时查阅和回顾。
LLM 与 Agent 学习路线图:从模型原理到工程落地 置顶!
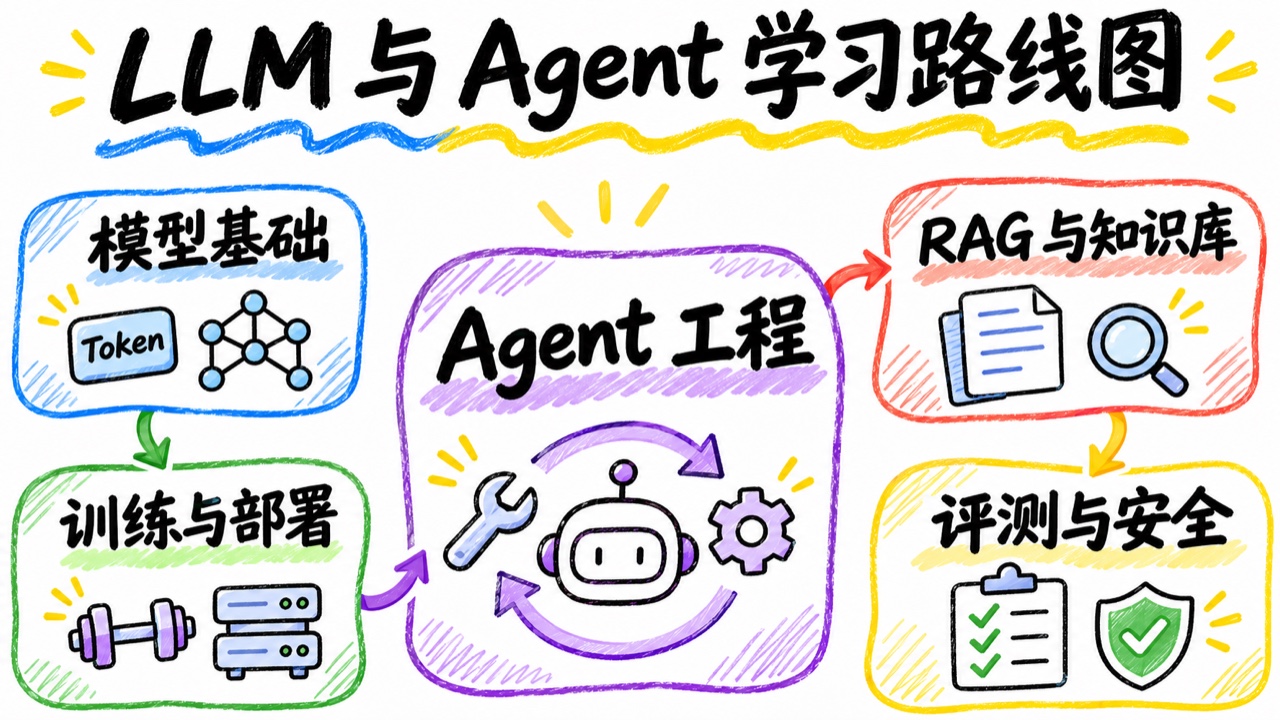
生成工具:Codex
生成模型:GPT-6
主线从一条真实请求出发:文本 → Token → 模型推理 → HTTP 与流式返回 → Agent 执行工具 → 检索证据 → 累积知识。先搞清每层的输入、输出和状态归属,再进入框架和生产架构。
| 顺序 | 专题系列 | 先修 | 阶段产物 |
|---|---|---|---|
| 1 | LLM 基础与推理(F) | Python、矩阵和概率直觉 | 解释一条提示从 Token 到首个输出 |
| 2 | LLM API 与流式协议(API) | F-01~F-04、HTTP/JSON | 用原始 HTTP 跑通文本、SSE 和工具调用 |
| 3 | LLM 效果评测(LE) | API-01~API-04 | 用同一组样本比较模型和 Prompt |
| 4 | 模型预训练与后训练(TRN) | Tokenizer、因果语言模型、训练损失与 LE 的评测口径 | 跑通微型预训练和一次 Qwen 微调,产出可复现的模型版本 |
| 5 | 推理引擎与模型部署(SERV) | Prefill、KV Cache、Chat Completions 与 SSE | 在 vLLM 与 SGLang 部署同一模型并按服务目标对照 |
| 6 | Agent、Context 与 Loop Engineering(AGT) | 文本和工具协议、上下文预算 | 写一个可终止、可恢复的 Agent |
| 7 | Agent 效果评测(AE) | Agent Loop、工具执行、LE | 重复运行任务,验证产物、副作用和轨迹 |
| 8 | RAG 与 LLM Wiki(KB) | 上下文组装、LE 与 AE 的基本口径 | 对同一批资料交付可溯源问答与知识页 |
| 9 | LLM 与 Agent 安全护栏(SEC) | 模型、工具和检索的信任边界 | 用 OWASP 清单做威胁建模和控制映射 |
| 10 | Sandbox 分类、源码与实测(SBX) | SEC、进程与容器基础 | 按相同任务与威胁模型对照执行环境 |
| 11 | Agent 自进化(EVO) | 短长期记忆、Skills、评测与写入护栏 | 让通过验证的经验成为可回滚的新版本 |
| 12 | OpenClaw 与 Hermes Agent 源码案例(CASE) | Harness、会话、Skills、隔离与自进化 | 对照同一任务在两个框架里的运行与经验沉淀 |
| 13 | Vibe Coding 与工程化交付(DEV) | Agent Harness、评测、护栏与 Sandbox | 对比原型与可维护版本的验收证据 |
| 14 | 生产化(OPS) | 服务、评测、隔离与任务执行链路 | 用运行指标说明上线、限流、隔离和拆分决策 |
本路线用 TTFT(Time to First Token)称呼首 Token 延迟。GRPO(Group Relative Policy Optimization)归入后训练。F-11 解释组内相对奖励,TRN-08 再把 GRPO 放进强化学习的采样、奖励与更新链路,GQA 和 GPTQ 分别留在注意力结构与量化。 DeepSeekMath / GRPO 原论文 · GQA 论文 · GPTQ 论文
1. LLM 基础与推理
建议先跑 Tokenizer,再钻进 Transformer。读到注意力时,已经知道输入序列和张量的含义。以 decoder-only 文本模型为主,图像、语音和后训练放到基础推理之后。
| 编号 | 可独立成文的题目 | 写清的机制与验证 |
|---|---|---|
| F-01 | Tokenizer 与 Chat Template | Token、ID、词表、子词与特殊 Token。打印中文、英文、代码的编码,再把一组角色消息套进模型模板,比较序列与 Token 数。 |
| F-02 | Transformer 如何从 Token 算出 logits | Token Embedding、位置编码、因果遮罩、Q/K/V、FFN、残差与输出头。画出几个 Token 经过一层时的张量形状。 |
| F-15 | Encoder-only、Decoder-only 与 Encoder-Decoder | 用同一段文本对照双向注意力、因果注意力和编码器与解码器之间的交叉注意力。以代表性模型区分训练目标和输出形式,说明向量表示、重排打分与生成怎样接到 KB-02、KB-04 和 KB-05。 |
| F-03 | MHA、MQA、GQA 与 RoPE | 拆开位置表示和注意力头设计。以相同 Query 头数画三种 K/V 共享关系,算 GQA 对 KV 容量的影响。 |
| F-13 | MoE 如何选择专家与分配计算 | 在稠密 FFN 基础上看 Router、Top-k、专家 FFN 与结果聚合,区分总参数和每 Token 激活的参数。用小例子统计各专家的 Token 数与负载倾斜,给 SERV-10 的专家并行预备背景。 |
| F-04 | 自回归生成与采样 | logits、Softmax、Greedy、Temperature、Top-k、Top-p、EOS、停止条件与最大输出。用小词表推演两步输出。 |
| F-05 | Prefill 与 Decode | 输入序列前向计算出首步 logits,生成阶段逐步追加 Token。画时间线,并跟踪第一步生成与后续步。 |
| F-06 | KV Cache 如何加速 Decode | 展示各层 K/V 随序列增长的形状、显存公式及读取成本。区分单序列增量缓存、跨请求前缀复用和应用结果缓存。 |
| F-14 | FlashAttention 如何减少注意力的显存读写 | 从 HBM 与片上存储、分块、在线 Softmax 理解精确注意力的 I/O 优化。对照朴素实现,固定输入测输出误差、峰值显存与耗时,再与 SERV-04 的 KV 块管理对照处理对象。 |
| F-07 | TTFT、TPOT、ITL、吞吐与端到端延迟 | 分清引擎首 Token、服务首事件、浏览器首段可见文本。固定输入和输出长度做实验,标出排队、Prefill、Decode 和传输,使曲线可解释。 |
| F-08 | 模型精度与量化 | FP16、BF16、INT8、INT4,权重量化与 KV 量化的对象不同。以 GPTQ/AWQ 为例讨论加载、硬件、内存与质量。 |
| F-09 | 多模态请求如何进入模型 | 从图片编码、视觉表示与文本融合,到 API 内容块。用文本和图文请求对照输入预算与输出,音频和实时双向流作为后续分篇。 |
| F-10 | 模型从训练到可用的过程 | 预训练、SFT、偏好优化和强化学习后训练,分清 LoRA 和训练目标的关系。基础服务实验可先于本篇。 |
| F-11 | GRPO 如何用于推理模型后训练 | 先理解奖励与策略更新,再用一组候选答案解释组内相对优势。讨论奖励设计、评测污染和训练后能力回归。可在 LE-02 之后回读。 |
| F-12 | 推理时计算与 Reasoning 模型 | 区分一般自回归解码、供应商暴露的推理预算、采样后验证三层。用同一组有正确解的题比较可配置推理强度,报告正确率、计费 Token、延迟与超预算率。 |
基础阅读:Transformer 论文 · Transformers Encoder-Decoder 文档 · Hugging Face Chat Templates · KV Cache 机制 · OpenAI Reasoning 模型指南 · Switch Transformers · FlashAttention
2. LLM API 与流式协议
全章用同一条普通消息和同一个无副作用函数走通协议。先抓原始 HTTP 请求和事件,再用 SDK 复现。真实在线 API 的字段与模型能力按文章写作时的官方文档复核。
| 编号 | 可独立成文的题目 | 写清的机制与验证 |
|---|---|---|
| API-01 | 从原始 HTTP 请求认识 LLM API | 请求头、JSON 体、认证、模型 ID、HTTP 错误、限流和用量。用最小请求记录输入、输出、用量及失败响应。 |
| API-02 | OpenAI Chat Completions 的消息协议 | POST /v1/chat/completions、messages、choices、终止原因。追踪两轮问答,说明应用如何保存与回传历史。 |
| API-10 | Prompt Engineering 的可复现对照实验 | 对同一个 CSV 报告任务比较朴素提示、明确统计口径、加入少量示例三个版本。固定模型、采样与留出集,一次只改变一项,记录格式通过率、业务正确率和输入 Token,保存失败样例供 LE-04 回归。 |
| API-03 | 从 Chat Completions、Assistants 到 Responses | 以 Chat Completions 的 Messages、Assistants 的 Thread/Run、Responses 的 typed Items 为轴;用两轮文本和一次工具调用做字段迁移对照。 |
| API-04 | Function Calling 与 Structured Outputs | 工具定义、JSON Schema、调用 ID、参数校验、调用结果回填。区分用于回答的结构化输出与触发应用动作的工具调用,验证坏参数和多工具返回。 |
| API-09 | 约束解码如何生成符合 Schema 的结构化输出 | 用一个小 JSON Schema 追踪约束状态和可选 Token,比较自由生成、JSON 模式、Schema 约束及应用侧校验。覆盖合法结构中的错误业务值、输出截断和拒答,按引擎版本验证支持范围。 |
| API-05 | SSE 和流式工具调用 | 区分 TCP/HTTP 数据块、SSE 帧、模型增量事件及 UI 文本。对比 Chat Completions 的 delta 与 Responses 的类型化事件,处理参数分片、UTF-8 跨块、结束、断线和取消。 |
| API-06 | Anthropic Messages API 的内容块与事件 | 从 POST /v1/messages 开始,拆解顶层 system、内容块、tool_use 与 tool_result。对照流式块索引与事件,通过一个示例和 OpenAI 请求往返映射。 |
| API-07 | 模型协议适配与能力矩阵 | 建立消息、文本事件、工具事件、错误和用量的内部类型。保留供应商特有能力,逐条验证多模态、工具、结构化输出、流式及状态管理。 |
| API-08 | 实时语音 Agent 的双向流 | 基于 F-09 和 API-05,画出浏览器采集、双向媒体、语音活动检测、打断和播放队列。对照 WebRTC 与 WebSocket 的连接边界,用一次打断测停止播放时间。 |
演进锚点为 2023-03 Chat Completions → 2023-06 Function Calling → Assistants 的 Thread/Run 模型 → 2025-03 Responses。重点追踪 API 的输入输出、状态归属与自定义工具由谁执行。 ChatGPT API 发布 · Function Calling 发布 · Responses 发布 · OpenAI 迁移指南 · Anthropic Messages 流式文档 · OpenAI Realtime 会话 · Structured Outputs · Prompt Engineering 指南
3. LLM 效果评测
固定任务定义、样本、输入模板、模型版本、采样与评分规则,再比较模型或 Prompt。这里评的是模型输出及应用的单步生成效果,Agent 的环境状态与执行过程在「Agent 效果评测」阶段展开。
| 编号 | 可独立成文的题目 | 写清的机制与验证 |
|---|---|---|
| LE-01 | 从业务目标到数据集、基线和评分 | 黄金样本、边界样本、失败样本、独立测试集。用准确率、结构校验或人工标准计分,记录数据版本、样本分层和失败类型。 |
| LE-02 | 公开基准怎样比较模型 | 用小子集练习 exact match、pass@k 与多轮采样。记录提示模板、few-shot、解码和抽取规则,讨论污染、样本量、适用范围与成本。 |
| LE-03 | LLM-as-a-Judge 与人工校准 | 对开放文本定义评分准则,以人工标注集校准,检查位置偏差、长度偏差和评分稳定性。可确定的数值、Schema 和引用用硬断言。 |
| LE-04 | 把效果评测接入 Prompt 和模型回归 | 固定数据版本和脆弱样本,输出分项指标与失败例,设发布阈值。比较准确性、成本和延迟变化。 |
| LE-06 | 长上下文的有效性如何评测 | 把同一份 CSV 数据字典的关键证据分别放到输入头、中、尾,改变文档长度和干扰项,测正确率、引用、TTFT 与成本。学完 KB-05 后用同一数据对照全量上下文与 RAG,供 AGT-04~05 验证裁剪和压缩。 |
| LE-05 | 模型改了,线上效果真的变好了吗 | 先用固定样本做成对比较和分层误差分析,再设计只读流量的影子评测或用户级灰度对照。记录随机分配、版本、人工接管率与回滚阈值,用区间说明样本不确定性。 |
开源项目按用途选。模型公开基准先读 lm-eval,需要多维场景和可复查报告时读 HELM。应用级的 Prompt 与模型对照先用 Promptfoo 跑小回归集。项目能力以仓库文档为依据,实际版本和数据集许可在写作实验时确认。 EleutherAI lm-evaluation-harness · Stanford HELM · Lost in the Middle · LongBench · Promptfoo
4. 模型预训练与后训练
先用极小的 decoder-only 模型理解「数据怎么变成权重」,再用已有 Qwen 模型做适配。教学预训练用小语料和小模型演示原理,微调实验需固定可用显卡、框架版本和模型 revision。需要先做 Agent 或 vLLM 的读者可以用已有权重进入 SERV,再回到本节。
| 编号 | 可独立成文的题目 | 写清的机制与验证 |
|---|---|---|
| TRN-01 | 预训练语料与 Token 数据管线 | 记录数据来源与许可,做清洗、去重、分词、样本打包和文档级切分。检查训练语料与验证题重叠,展示一个训练 batch 的输入和移位标签。 |
| TRN-02 | 从随机权重预训练一个微型语言模型 | 跟一批 Token 通过前向、下一 Token 交叉熵、反传、梯度累积、优化器和 Checkpoint,观察训练与验证损失。读 nanoGPT 的训练循环做源码对照,验证保存后续训。 |
| TRN-10 | 分布式训练的显存账本,FSDP 与 ZeRO | 先区分参数、梯度、优化器状态和激活的开销,再画 FSDP 与 ZeRO 的分片、通信和 Checkpoint。以单卡训练为基线,有多卡时固定全局 batch 比较峰值显存、训练吞吐和恢复行为。可在需要多卡时回读。 |
| TRN-03 | 选继续预训练、SFT 还是偏好优化 | 继续预训练使用领域原文,SFT 使用示范答案,偏好优化使用选优数据或奖励信号。将训练目标与参数更新范围分开讨论,比较全参数、部分层、Adapter 和软提示,记录质量、显存及数据门槛。 |
| TRN-04 | SFT 怎么把对话变成监督信号 | 用同一 Chat Template 构造报告问答,明确哪些 Token 参与 loss。检查多轮标签遮罩、截断与 EOS,用留出集比较基座、提示词基线与微调模型。 |
| TRN-05 | LoRA 与参数高效微调 | 画出冻结权重和低秩增量,用目标层、rank 和可训练参数量解释成本。比较独立 Adapter 加载、合并权重和切换 Adapter,并核对基座版本。 |
| TRN-06 | QLoRA、训练量化和部署量化 | 用低比特冻结基座训练 LoRA,解释权重存储精度、计算精度及 Adapter 的角色。回接 F-08,区分 QLoRA、推理 PTQ、训练感知量化 QAT 和 KV Cache 量化。记录显存、质量、格式、引擎与硬件兼容性。 |
| TRN-07 | 偏好数据、奖励模型与 DPO | 构造同一问题的 chosen/rejected,解释偏好标签、参考策略与数据偏差。比较 SFT 和 DPO 的留出集结果,注明 DPO 的离线偏好数据路径。 |
| TRN-08 | LLM 强化学习,从 PPO 到 GRPO | 讲在线采样、奖励、优势估计、策略更新与 KL 约束的作用,以 PPO 型 RLHF 和 GRPO 的组内相对奖励做对照。用可验证答案演示奖励和验证集,并检查奖励投机、输出长度和通用能力回归。 |
| TRN-11 | 知识蒸馏与学生模型评测 | 区分教师软标签与教师生成的答案。固定学生基座、数据切分和训练预算,对照普通 SFT 与加入教师信号后的结果,报告任务收益、通用能力回归和数据成本。 |
| TRN-12 | 合成训练数据与质量控制 | 围绕 CSV 报告任务生成候选指令与样本,用可执行的统计结果校验答案,再做去重、覆盖率检查和人工抽查。记录生成来源、过滤规则与数据版本,用隔离的人工留出集比较仅用原始数据与加入合成数据后的效果。 |
| TRN-09 | 用 Unsloth 跑通一次微调、评测和导出 | 固定基座、数据、模板、硬件和依赖,用 Unsloth 做一次 LoRA 或 QLoRA SFT,与 Transformers、PEFT、TRL 的职责对照。保存 Adapter,按部署后端决定独立加载或合并,并用固定样本做导出前后回归。 |
工具分工可用一条链路理解。Transformers 提供模型与 Tokenizer,PEFT 提供参数高效适配,TRL 提供 SFT、偏好与强化学习训练器,Unsloth 用于这一支线的训练实战、运行和导出。对照同一模型和任务时,先统一数据、模板和评测口径。 nanoGPT · TRL 文档 · PEFT 量化指南 · Unsloth 文档
原理阅读:LoRA · QLoRA · DPO · PPO · GRPO · PyTorch FSDP · DeepSpeed · 知识蒸馏论文 · Self-Instruct
5. 推理引擎与模型部署,vLLM 和 SGLang
教学模型选 Qwen/Qwen2.5-0.5B-Instruct。正式动手时记录模型 revision、vLLM tag、硬件与后端。Linux + NVIDIA CUDA 可作为主实验环境,CPU 或 Apple Silicon 的安装路径、支持的数据类型和性能需按选定版本实测。首个实验验证普通文本与流式文本,工具调用能力按模型、模板和解析器另测。 Qwen 模型卡 · vLLM Quickstart · vLLM CPU 安装说明
| 编号 | 可独立成文的题目 | 写清的机制与验证 |
|---|---|---|
| SERV-01 | 用 Qwen 0.5B 搭一个极简 vLLM Server | 固定环境后启动 vllm serve Qwen/Qwen2.5-0.5B-Instruct,验收模型列表、普通 Chat Completion、流式 Chat Completion,记下生成参数与实际 Token 用量。 |
| SERV-02 | 一次请求从浏览器到引擎再回浏览器 | 浏览器 fetch POST → 应用后端按需代理 → vLLM HTTP 路由与输入处理 → 引擎调度 → 模型 Worker → Token 解码与 SSE → 客户端增量渲染。记录同一请求 ID 及各层时间。 |
| SERV-03 | 读 vLLM V1 源码,从路由跟到模型前向 | 在固定 tag 下记录实际文件和方法:入口与 Chat 路由、模板及 Tokenization、异步引擎客户端、Engine Core、Scheduler、Worker 和输出处理。用一条短请求标出进程、任务及数据结构的交接。 |
| SERV-04 | PagedAttention、Continuous Batching 和 Prefix Cache | 按请求画 KV 块分配及调度过程。比较同前缀、不同前缀与不同并发,测缓存利用率、排队、TTFT、ITL 和吞吐。 |
| SERV-05 | 端到端流式调试和取消 | 记录第一个 HTTP 字节、第一条 SSE、第一段可见文字和结束事件。定位代理缓冲、HTTP/SSE 分帧、慢消费者、客户端取消与服务端请求回收。 |
| SERV-06 | Chunked Prefill 与 Speculative Decoding | 对比输入调度与输出生成的优化目标。固定模型、硬件和数据,分别做单因素实验,记录并发、TTFT、ITL、吞吐,启用投机解码时再记录草稿接受率。 |
| SERV-07 | SGLang 源码与 vLLM 对照 | 让同一个 Qwen 模型跑通 OpenAI 兼容请求,固定版本跟 Scheduler 与 RadixAttention 前缀复用。与 SERV-03~SERV-04 对照缓存、批处理和流式输出;工具及结构化能力按版本实测。 |
| SERV-12 | 模型注册、产物血缘与版本发布 | 用 MLflow 建立从实验、数据和评测到发布模型的关联,固定基座、Tokenizer、模板、Adapter 与量化配置。用一条请求的发布 ID 查回完整产物,并演示恢复到上一组通过验证的版本。 |
| SERV-08 | 从训练产物部署成单机推理服务 | 从基座、Tokenizer、模板、Adapter 或合并权重和量化产物生成部署清单。比较适配器挂载与合并两种路径的兼容性,验证容器、健康检查、模型预热、限流、流式断开和旧版本回滚。 |
| SERV-13 | 本地推理与模型格式,llama.cpp 和 MLX-LM | 在 Apple Silicon 上从同一个 Qwen 基座准备 GGUF 与 MLX 权重,核对 Tokenizer、Chat Template、量化方法和实际硬件后端。对照加载时间、峰值内存、TTFT、输出速率和样本质量。 |
| SERV-09 | 部署优化,从显存预算到延迟与吞吐 | 先算权重、KV Cache 与工作区显存,再用输入长度、输出长度、到达速率和并发构造负载。依次测试批处理、缓存、量化和预热,标注 OOM、队列、TTFT、ITL、P95 和满足延迟目标的吞吐。 |
| SERV-14 | GPU 性能剖析,从请求时间线到内核 | 在固定输入、输出和并发下,用 Nsight Systems 对齐 Prefill、Decode、CPU 调度、数据搬运与 CUDA 内核。先定位等待或计算热点,再验证一次配置变更对延迟和吞吐的影响。 |
| SERV-10 | 多 GPU 与分离式推理部署 | 学数据并行、张量并行、流水线并行,MoE 再看专家并行。解释显存、通信和节点拓扑;Prefill/Decode 分离作为进阶,测 KV 传输开销与跨节点尾延迟。 |
| SERV-11 | 两种引擎的生产基准与选型报告 | 使用相同模型权重、量化和采样配置、请求流和硬件,区分冷暖缓存。先验证结果、协议和取消语义,再对照延迟、吞吐、每成功请求成本和操作复杂度。 |
| SERV-15 | 推理服务容量规划与弹性伸缩 | 从目标 P95 和请求长度分布推导单副本容量。用稳态和突发流量比较队列长度、在途请求与 GPU 利用率作为扩缩容信号,观测新副本就绪、预热、缩容抖动、达标吞吐和成本。 |
| SERV-16 | 离线批量推理与异步作业 | 用同一批文档做字段抽取,比较在线并发请求与提交离线批次。给任务和输入行分配稳定 ID,验证乱序结果关联、部分失败后按失败项重跑及重复结果去重,衡量整批完成时间和单位成本。说明异步提交与 SERV-04 的引擎内部批处理如何处在不同层。 |
源码文章以 一条请求的跟踪记录 为验收。至少展示实际请求体、模板结果或 Token IDs、调度与输出事件、浏览器可见结果。对客户端取消,实测引擎是否回收同一请求。OpenAI 兼容接口按实际覆盖范围写,示范用 Chat Completions,Responses 和 Anthropic 形态另做兼容性对照。 vLLM V1 架构 · vLLM Prefix Cache · PagedAttention 论文 · vLLM 调度与调优 · vLLM 投机解码实验 · vLLM Benchmark CLI · SGLang 文档 · MLflow Model Registry · llama.cpp · MLX-LM · Nsight Systems · vLLM 指标 · OpenAI Batch API
6. Agent、Context Engineering、Loop Engineering 与 Harness
用「上传 CSV → 查询数据 → 生成报告 → 确认后归档」贯穿。Context Engineering 设计每轮模型看见什么,Loop Engineering 在本路线中是反馈闭环的工程设计,关注任务如何推进、失败如何修复及怎样判定完成。Harness 把两者接到模型、工具、状态、权限和运行环境中。按表格顺序学习,新增专题沿用新编号。
| 编号 | 可独立成文的题目 | 写清的机制与验证 |
|---|---|---|
| AGT-01 | 从工具调用到 Agent Loop | 模型提出动作 → 运行时校验并执行 → Observation 回填 → 下一轮。实现最终答案、澄清、失败、取消、步数与预算终止。 |
| AGT-17 | Context Engineering 总览 | 画上下文数据流,定义权威状态、可检索资料、工具观察和历史的作用域。按任务阶段决定选择、组装、压缩和回读,并用上下文快照回归。 |
| AGT-02 | 上下文组装与 Prompt 层级 | 组装系统约束、任务状态、相关历史、工具定义、检索证据。打印一轮实际 Prompt,说明外部工具输出的信任边界。 |
| AGT-03 | 超长工具输出怎么处理 | 执行器限额、服务端聚合、按样本和区间取证、产物外置、引用回读。用几万行日志验证错误在中间仍能定位。 |
| AGT-04 | 上下文裁剪 | 计算可用 Token 预算,裁掉冗余或过时内容,维护工具调用配对,保留早期关键约束。用固定回放验证裁剪前后同一任务。 |
| AGT-05 | 上下文压缩 | 把旧阶段整理为结构化摘要,保留来源、决策、产物和待办。注入摘要与执行状态冲突,验证状态恢复不重复提交。 |
| AGT-06 | 短期记忆与 Checkpoint | 区分本次模型输入、任务状态和会话历史。模拟执行中断与恢复,验证同一会话能继续。 |
| AGT-07 | 长期记忆的写入、检索与治理 | 以跨会话偏好为例,记录命名空间、来源、版本和删除规则。测试显式偏好更新、误记、串租户和索引残留。 |
| AGT-08 | 工具超时、取消、重试与幂等 | 区分网络故障、参数错误、超时未知结果和可安全重试动作。验证已成功但未收到回执的恢复路径。 |
| AGT-09 | 工具并发与依赖调度 | 用依赖图区分可并行读、冲突写和顺序约束。处理并发配额、部分失败、结果乱序和取消传播。 |
| AGT-10 | 工具太多时如何做工具治理 | 权限过滤、按域分组、候选召回、Schema 精简、按需加载。测正确工具召回率与选中率,区分召回和选择错误。 |
| AGT-11 | MCP、Tools 和 Skills 的职责 | 画出一轮工具执行。Tool 是可调用能力,MCP 连接宿主与能力服务,Skill 封装一套可复用的任务说明和配套材料。标明真正做授权与执行的层。 |
| AGT-19 | MCP Server 原理与协议生命周期 | 画清 Host、Client、Server,以及 Tools、Resources、Prompts。固定协议版本,对照初始化和能力协商、发现和调用,拆解 stdio 与 Streamable HTTP 的交互。 |
| AGT-20 | 从零实现一个最小 MCP Server | 用官方 SDK 暴露只读的 CSV 列统计工具和数据字典资源。先用客户端观察原始协议,再接入 Agent,验证 Schema、错误、超时和输出预算,讨论本地与远程授权边界。 |
| AGT-21 | Agent Skills 的设计、加载与测试 | 用 SKILL.md 的元数据做发现,命中后读取任务说明,需要时再读脚本或参考资料。把报告口径写成 Skill 并在两个可用宿主验证触发、版本与权限。 |
| AGT-18 | Loop Engineering 与反馈闭环 | 练习规划 → 执行 → 核验 → 修复,设计明确验收、无进展检测、重试预算与停止条件。对比单轮工具循环、外层反馈循环和跨会话接力,验证失败时能够退出或交给人工。 |
| AGT-12 | Agent Harness 源码阅读 | 先用自己的最小 Loop 对照,再选 Pi 或 OpenHands,固定 tag 追踪一条消息从会话状态、Loop、工具执行与事件发布到结果。标出模型适配、文件及环境接入、生命周期和权限边界。 |
| AGT-13 | Workflow、Agent 与混合编排 | 对照顺序链、路由、并行汇聚、评估再改写和自主循环。用同一任务演示确定性步骤、开放决策与人工审批如何组合。 |
| AGT-14 | 多 Agent 协作的几种模式 | 编排者与 Worker、按域 Handoff、生成者与评审者、共享任务队列。比较任务依赖、上下文隔离、合并与冲突、共享写入权限和成本。 |
| AGT-22 | A2A 协议与跨 Agent 委派 | 固定协议版本,读 Agent Card、Message、Task 和 Artifact。对照本进程内的 Handoff 与跨服务委派,明确能力发现、身份和任务所有者。 |
| AGT-15 | Agent 的长任务与人机协作 | 持久化状态机、等待审批、断点续跑、事件重放、重复投递。复现 Worker 中断和用户重连。 |
| AGT-24 | 持久化工作流的事件重放与状态恢复 | 用 Temporal 对照手写 Checkpoint,把模型和外部写操作放进 Activity,说明确定性重放与 Activity 重试的关系。暂停 Worker 后恢复,验证已记录结果继续使用,未知副作用按业务动作 ID 核对。 |
| AGT-23 | A2A 实战,两个 Agent 如何交接长任务 | 让报告 Agent 委派只读校验,并获取状态或产物。演示同步结果和流式状态,按所选协议版本验证取消、失败与断线后的状态查询。用应用层关联 ID 避免误提交,明确产物访问授权。 |
| AGT-16 | Agent 运行轨迹与调试 | 为模型、工具、状态和产物加关联 ID,跟踪一次任务为什么失败。保留脱敏轨迹供下一章做批量评测。 |
| AGT-25 | Agent 前端事件协议与生成式 UI | 用 AG-UI 展示运行状态、工具进度与一次审批,用 A2UI 的声明式组件描述呈现报告卡片。复用 API-05 的流式传输知识,区分事件协议与 UI 描述,验证断线后的状态恢复、审批绑定和取消。 |
延伸阅读:Anthropic Agent 架构模式 · Anthropic 上下文工程 · Anthropic 多智能体实录 · LangChain Memory · Anthropic 长任务 Harness
协议实战共用一个案例。MCP Server 暴露列统计和数据字典,Agent Skill 说明报告口径与验收步骤,A2A 负责把整项复核工作交给另一个独立 Agent 并取回产物。A2A Agent Card 中的 skill 是能力描述,Agent Skills 规范中的 Skill 是以 SKILL.md 为入口的内容包。实验记录协议和 SDK 版本。 MCP 规范 · MCP TypeScript SDK · Agent Skills 规范 · A2A 核心概念 · AG-UI · A2UI
源码对照从 Pi 的 Agent Loop 入手,需要看独立运行环境与更完整的 Coding Agent 时再读 OpenHands。两者都按固定 tag 验证一条调用路径。 Pi · OpenHands · Temporal Workflow 与重放
7. Agent 效果评测
先固定数据、工具权限、初始环境、任务预算以及最终可观察状态。用同一套任务对比单 Agent、编排策略或 Harness 改动。结论同时覆盖产物正确性、业务副作用和执行成本。
| 编号 | 可独立成文的题目 | 写清的机制与验证 |
|---|---|---|
| AE-01 | 设计 Agent 任务集与环境夹具 | 每题定义用户目标、初始状态、允许工具、验收产物和业务约束。每次试验重置环境,支持固定工具返回和真实集成两种模式。 |
| AE-02 | 结果评测、轨迹评测和随机性 | 先断言最终状态、产物正确和写入次数,再检查选择错误、冗余步骤、超时与越权。对允许多个解法的任务评约束与结果,重复运行并报告成功率、波动、耗时和成本。 |
| AE-03 | 使用开源框架评测自己的 Agent | 用 Inspect AI 把 CSV 报告任务组织成样本、Agent 与评分器,接上模拟工具和可信状态断言。将线上脱敏失败轨迹用于离线回归。 |
| AE-04 | 用开源 Benchmark 对照 Agent 能力 | 用 SWE-bench 理解代码修复与测试验收,用 τ²-Bench 理解工具、用户模拟和业务终态评分。记录模型、Harness、工具权限、环境和运行预算。 |
| AE-05 | 进阶实验,Agent 的多轮强化学习 | 先读 TRN-08 和 AGT-01,使用已有 Agent 评测作基线。在可重置的模拟报表环境中收集多轮工具交互轨迹,比较终态奖励与加入步骤奖励后的成功率、无效动作、步数和奖励投机。用未见任务复测,并与 EVO-01 中的运行时经验更新对照。 |
Inspect AI 用于搭建和运行自有任务。SWE-bench、τ²-Bench 用于特定场景的对照。需要把线上轨迹与质量评分关联时可调研 Langfuse,并验证采集字段、脱敏和留存策略。 Inspect AI Agent 文档 · SWE-bench · τ²-Bench · Langfuse · TRL 环境训练 · verl Agentic RL
8. RAG、Embedding、Rerank 与 LLM Wiki
用同一小批原始文档做三次迭代:先做可引用的基础 RAG,再加排序与评测,最后编译成可维护的 Wiki,并以原始资料补证。
| 编号 | 可独立成文的题目 | 写清的机制与验证 |
|---|---|---|
| KB-11 | 复杂文档解析,OCR、版面、表格与引用 | 用扫描 PDF 和跨页表格比较纯文本抽取与保留版面的解析,检查 OCR、阅读顺序、表头归属、单元格和页码引用。记录失败样例,完成 KB-05 后用同一问题集测解析误差如何传到召回与答案。 |
| KB-01 | 文档解析、切块与索引 | 保留标题层级、原文位置、版本和访问权限,对比固定窗口与结构切块。修改原文后验证相关索引能更新。 |
| KB-02 | Embedding 与向量相似度 | Query/Document 表示、余弦与内积、归一化与模型迁移。用同义句、专有名词和编号测向量召回。 |
| KB-03 | BM25、向量检索与混合召回 | 用同一文档集比较倒排与向量结果,讨论 ANN 的速度与召回权衡,展示候选融合与权限过滤。 |
| KB-04 | Rerank 怎样改善证据排序 | 区分初召回与二阶段重排,用 Cross-Encoder 为候选重新打分。比较 Recall@K、MRR 或 nDCG、延迟和成本。 |
| KB-05 | 从候选证据到可引用的 RAG 回答 | 检索 → 重排 → 证据选择和组装 → 生成带引用答案。测引用正确性、证据不足时的拒答、跨文档冲突和索引过期。 |
| KB-08 | RAG 的端到端质量评测 | 分开检查召回覆盖、证据相关性、答案忠实度和引用正确性。用人工标注校准自动指标,再按失败位置定位到文档、检索、重排或生成。 |
| KB-09 | 多租户 RAG 的索引权限与删除传播 | 追踪文档授权和版本如何传到切块、召回过滤、重排和引用接口。撤权或删除后检查旧索引、缓存与引用访问,并验证更新期间的拒绝与恢复行为。 |
| KB-10 | 结构化数据 Agent,Text-to-SQL 与指标口径 | 将 CSV 导入测试数据库,比较固定参数查询与生成 SQL。用数据字典和已知结果核对连接、去重、空值、时间范围与聚合口径,同时验证只读身份、查询预算、拒绝路径和结果引用。 |
| KB-06 | Agentic RAG 与多跳检索 | 把检索作为有预算的工具,演示查询重写、补充检索、条件停止。用单轮 RAG 做基线,验证重复检索和成本。 |
| KB-07 | LLM Wiki 的资料编译、查询与维护 | 原始资料层、Wiki 页面层、Schema 与维护规则。用同一小批资料走 ingest → query → lint,验证来源链接、重复主题、冲突、增量更新与失效。Wiki 用于累积综合知识,查询可结合检索回查原文。 |
评测实验可用 Ragas。
经典 RAG 论文提供原理起点,系列案例采用现代常见的检索工程链路。 RAG 原论文 · Karpathy 的 LLM Wiki 原文 · Azure AI Search 文档级权限示例 · BIRD Text-to-SQL 基准 · Docling
9. LLM 与 Agent 安全护栏
先画数据流和信任边界,明确模型、应用、工具代理以及隔离环境各自负责的控制。用合成数据与受控工具验证允许、拒绝、审计与恢复。
| 编号 | 可独立成文的题目 | 写清的机制与验证 |
|---|---|---|
| SEC-01 | OWASP 是什么,Top 10 怎样用 | 介绍 OWASP Foundation、GenAI Security Project 及风险清单的用途。为自己的系统建资产、威胁、控制、负责人和验证矩阵。 |
| SEC-02 | OWASP Top 10 for LLM Applications | 以 2026 版官方材料为主,逐项映射到模型输入、检索、输出处理、发布与运行环境。每类明确影响、缓解措施和防御验收。 |
| SEC-03 | OWASP Top 10 for Agentic Applications | 以 2026 版为主,结合 Agent 工具调用、身份与权限、记忆、跨 Agent 信任和供应链梳理风险。在同一个案例中对照两份清单的关注点。 |
| SEC-04 | LLM 应用的输入、输出和数据护栏 | 设计内容规则、敏感信息处理、输出 Schema、输出展示与下游执行约束。用合成正反样本观察误拦、漏判、延迟与失败处理。 |
| SEC-05 | Agent 工具调用、审批与运行时护栏 | 把租户授权、审批参数绑定、预算、日志和网络或文件策略落到执行边界。验证外部内容可以被读取,但其文字不能改变工具权限或审批要求。 |
| SEC-06 | 第三方模型、MCP Server、Skill 与 A2A 的信任链 | 记录服务身份、授权委派、版本来源、依赖与审批边界。用合成夹具验证第三方描述更新、授权撤回、权限范围收窄与执行审计。 |
护栏原型可读 NeMo Guardrails,用一个内容规则和一个工具审批流程对照应用层、工具代理和 Sandbox 的职责;涉及用户授权的决策由可信执行边界再次检查。 OWASP Foundation · LLM Applications Top 10 2026 · Agentic Applications Top 10 2026 · NeMo Guardrails · MCP 授权规范
10. Sandbox 分类、源码与实测
从两个维度分类。部署位置可分本机、远程自建和托管云。隔离机制可分语言运行时、宿主进程策略、共享内核容器、用户态内核以及 VM/MicroVM。浏览器、代码解释器和完整工作区属于使用场景。同一个产品在不同部署配置下可以对应不同隔离机制。
| 编号 | 可独立成文的题目 | 写清的机制与验证 |
|---|---|---|
| SBX-01 | 沙箱分类与威胁建模 | 比较 WASM、进程策略、容器、gVisor、MicroVM 与通用 VM 的信任边界。按宿主访问、网络、兼容性、启动和清理确定需求。 |
| SBX-02 | 本地沙箱如何限制 Coding Agent | 在本机分别看宿主进程权限策略与本地容器或 VM。用合成项目验证工作区读写、子进程、网络拒绝与资源回收,记录系统和策略版本。 |
| SBX-03 | 远程沙箱的生命周期与执行接口 | 追踪 create → exec → artifact → destroy,讲模板、文件与产物、网络、租约、多租户隔离、配额和故障恢复。 |
| SBX-04 | E2B、CubeSandbox、OpenSandbox 对比与源码路径 | 对照 SDK、控制面、执行面、网络和存储。E2B 先读托管 SDK 与开源仓库;OpenSandbox 先看 Docker 与 Kubernetes 运行时;CubeSandbox 跟 CubeAPI 到 Cubelet、KVM MicroVM。 |
| SBX-05 | 沙箱选型、启动基准与事件响应 | 用相同任务和依赖测申请到首命令、P95、清理和会话状态;用合成资源验证边界拒绝。将配置错误与疑似隔离失效分别纳入防御处置。 |
建议实验顺序为本地最小策略 → OpenSandbox 本地 Docker 生命周期 → E2B 托管 API 形态 → CubeSandbox 在具备 KVM 条件的主机上读源码并验证。可用 gVisor / Firecracker 辅助理解隔离层,用 Kata Containers 补充容器接口与 VM 的结合。各项目的许可证与托管条款、后端和平台要求按选定版本确认;仓库中的性能数字先看测试口径。 E2B 文档 · E2B 源码 · OpenSandbox · CubeSandbox 架构 · gVisor · Firecracker · Kata Containers
11. Agent 自进化
先分清本轮纠错、跨会话经验沉淀、框架配置迭代与模型权重更新。报告 Agent 在任务中重试属于执行反馈。把反复验证的处理方法保存成 Skill,可以改变未来行为。修改提示或路由策略属于应用配置变更,GRPO 则属于 F-11 的模型后训练。
| 编号 | 可独立成文的题目 | 写清的机制与验证 |
|---|---|---|
| EVO-01 | Agent 自进化有哪些模式 | 对照轨迹反思、事实记忆、过程知识或 Skills 沉淀,以及基于回归集调整 Prompt 与路由。用同一个用户纠正示例展示写入什么、何时召回、如何判断收益。 |
| EVO-02 | 从任务反馈到可审计的经验发布 | 选择有来源的有效经验 → 草拟候选记忆或 Skill → 用隔离回放和留出样本评测 → 审阅、版本化激活与回滚。验证任务收益、误记污染、作用域和权限边界。 |
实战以「前次报告把空值当成零,用户纠正了口径」为例,分别回放旧版和新版,区分当次数据规则与可跨任务复用的流程。候选经验只能调整已授权范围内的任务步骤,权限仍由可信运行时检查。 Hermes Skills 与经验沉淀 · Hermes Memory 与写入审批
12. OpenClaw 与 Hermes Agent 源码案例
两篇都固定源码 tag,从一条本地测试会话入手,记录入口、路由、模型调用、工具策略、会话持久化和结果返回。再挑同一处用户纠正,观察两个实现分别写入什么、在哪一轮加载以及如何撤销。
| 编号 | 可独立成文的题目 | 写清的机制与验证 |
|---|---|---|
| CASE-01 | OpenClaw 设计思想与运行链路 | 从 Gateway 与 Channel 接入出发,追踪会话路由、workspace、上下文与 Skills 快照、Agent Loop、工具和事件回流。区分同一会话的执行顺序与不同会话的隔离范围。 |
| CASE-02 | Hermes Agent 的设计思想与自改进链路 | 追踪一次 CLI 或 Gateway 会话,从 Agent Loop 到会话记录,再跟后台回顾、持久记忆和可复用 Skill 的写入路径。对照选定版本验证审批、编辑和下一会话的加载。 |
| CASE-03 | 同一个任务对照 OpenClaw 与 Hermes Agent | 比较接入方式、会话与工作区边界、指令加载、记忆与 Skill 生命周期、写入审批和可观测性。用同一份 CSV、同一模型和相同权限回放,按源码和观察记录作结。 |
阅读入口:OpenClaw Gateway 架构 · OpenClaw Agent Loop · Hermes Agent 源码 · Hermes Skills
13. Vibe Coding 与工程化交付
| 编号 | 可独立成文的题目 | 写清的机制与验证 |
|---|---|---|
| DEV-01 | Vibe Coding 的工作方式与原型实验 | 通过自然语言和界面反馈快速迭代一个报告页,记录迭代时间、人工干预和剩余缺陷。以可丢弃分支承载实验。 |
| DEV-02 | 从 Vibe Coding 原型走向 Agentic Engineering | 同一任务增加可验证规格、仓库约束、测试、版本隔离、权限和代码复核。对比测试覆盖、错误恢复、修改范围和可维护性。 |
| DEV-03 | Computer Use 与浏览器 Agent 的工程实践 | 用同一份本地示例报告比较 DOM/可访问性信息与截图操作的定位方式。验证点击后的页面状态、弹窗、误操作恢复、提交前审批和用户接管。 |
用长任务 Harness 的增量开发、产物接力和评估反馈作为工程化对照。 Anthropic 长任务 Harness · 生成与评估循环的工程案例 · Anthropic Computer Use 文档
14. 生产化专题
| 编号 | 可独立成文的题目 | 写清的机制与验证 |
|---|---|---|
| OPS-01 | LLM Gateway 的限流、路由、缓存与降级 | 按 RPM、TPM、并发、预算治理,测试 429、超时、部分流式输出和供应商切换。 |
| OPS-02 | Agent 安全控制如何落到生产环境 | 将 SEC 与 SBX 中的控制接入权限配置、网络策略、审计、变更审批与事件响应。用分环境回归确认策略实际生效。 |
| OPS-03 | Sandbox 冷启动和资源回收 | 拆分排队、镜像、运行时、首命令,比较镜像缓存、预热和洁净快照,追踪 P95、闲置成本、隔离与回收。 |
| OPS-04 | Agent 服务拆分与可靠迁移 | 从模块化单体拆异步执行池,覆盖队列、Outbox、幂等、独立扩缩容、灰度和回滚。 |
| OPS-05 | 端到端可观测与持续发布 | 统一请求、模型、工具和产物的追踪,制作失败样本、上线门槛、灰度与回滚报告。 |
| OPS-07 | Prompt、工具契约和在途任务的版本兼容 | 记录每次运行所用的 Prompt、工具输入与输出 Schema 以及模型发布版本。用统计工具的参数变更与结果变更演示兼容层和轨迹回放,验证旧任务恢复、灰度和回滚期间的结果一致性与副作用处理。 |
| OPS-06 | 用 OpenTelemetry 定位一条 Agent 慢请求 | 固定语义约定版本,用 Trace 关联模型、检索、工具和 Sandbox,把耗时拆成排队与执行。记录 Token、错误与步骤次序,用脱敏与采样保护输入输出。 |
生产链路观测参考:OpenTelemetry 的 GenAI Trace 示例
首轮写作主线
专题仍按各阶段的先修顺序展开。下面用 CSV 报告做五次交付,每次只引入当前需要的技术:
- 一次模型请求。 打印模板和 Token IDs,理解 Prefill 与 Decode。用 Chat Completions 播放一次真实 SSE,再固定样本做 Prompt 对照。
- 一个推理服务。 让 Qwen/vLLM 接入同一请求,记录引擎与浏览器的首 Token 或首字指标。
- 一个能执行工具的 Agent。 用单 Agent 调用只读统计工具,组装上下文,把结果和产物引用写入状态。用固定样本检查统计正确性。
- 一个会恢复、可验证的任务。 加入归档前确认、断点恢复、RAG 证据和授权测试。回归至少覆盖断流、重复执行与越权拒绝。
- 一个可追踪的交付。 通过隔离环境执行,连通模型、检索和工具 Trace,报告任务完成率、成本和 P95。按需要选做多 Agent、A2A、自进化或实时语音分支。
如果先写训练与部署,可从 TRN-02 的微型预训练起步,再完成 TRN-04~06 和 TRN-09 的 Qwen 微调与导出,最后执行 SERV-01、SERV-07、SERV-12、SERV-08~09、SERV-11 的服务、优化及选型实验。训练数据仍沿用 CSV 报告案例,服务端用同一组留出样本核对质量。DPO、PPO/GRPO 和多 GPU 部署可各自扩展为后续实验。
专题文章的固定结构
- 场景与先修。明确解决的问题、前置篇章和一个具体输入。
- 可观察协议。展示实际消息、Token、事件或状态,给出输出和边界。
- 机制与源码。按调用顺序跟到关键模块。涉及源码时记录版本、入口和行为。
- 最小实验与验收。提供可复现的请求或样本,验证成功路径、一个边界条件和必要指标。
- 关联阅读。链接上游与下一篇,以及可对照的官方文档、论文或对应题库题号。
编号用于写作索引,已有编号保留,新增编号按先修依赖插入相应位置。学习及写作顺序以章节与表格的实际行序为准。现有Agent 与 Sandbox 面试题库按面试分类保留题号。
标题:LLM 与 Agent 学习路线图:从模型原理到工程落地
作者:gitsilence
地址:https://lacknb.cn/articles/2026/11/19/1795058329577.html
- 1. LLM 基础与推理
- 2. LLM API 与流式协议
- 3. LLM 效果评测
- 4. 模型预训练与后训练
- 5. 推理引擎与模型部署,vLLM 和 SGLang
- 6. Agent、Context Engineering、Loop Engineering 与 Harness
- 7. Agent 效果评测
- 8. RAG、Embedding、Rerank 与 LLM Wiki
- 9. LLM 与 Agent 安全护栏
- 10. Sandbox 分类、源码与实测
- 11. Agent 自进化
- 12. OpenClaw 与 Hermes Agent 源码案例
- 13. Vibe Coding 与工程化交付
- 14. 生产化专题
- 首轮写作主线
- 专题文章的固定结构